特别感谢 谭升的博客!
这门课的核心并不是 CUDA 编程,所以有很多细节并没有体现在 slides 中,在一定程度上有些干扰对 CUDA 的理解。
03 CUDA programming 1
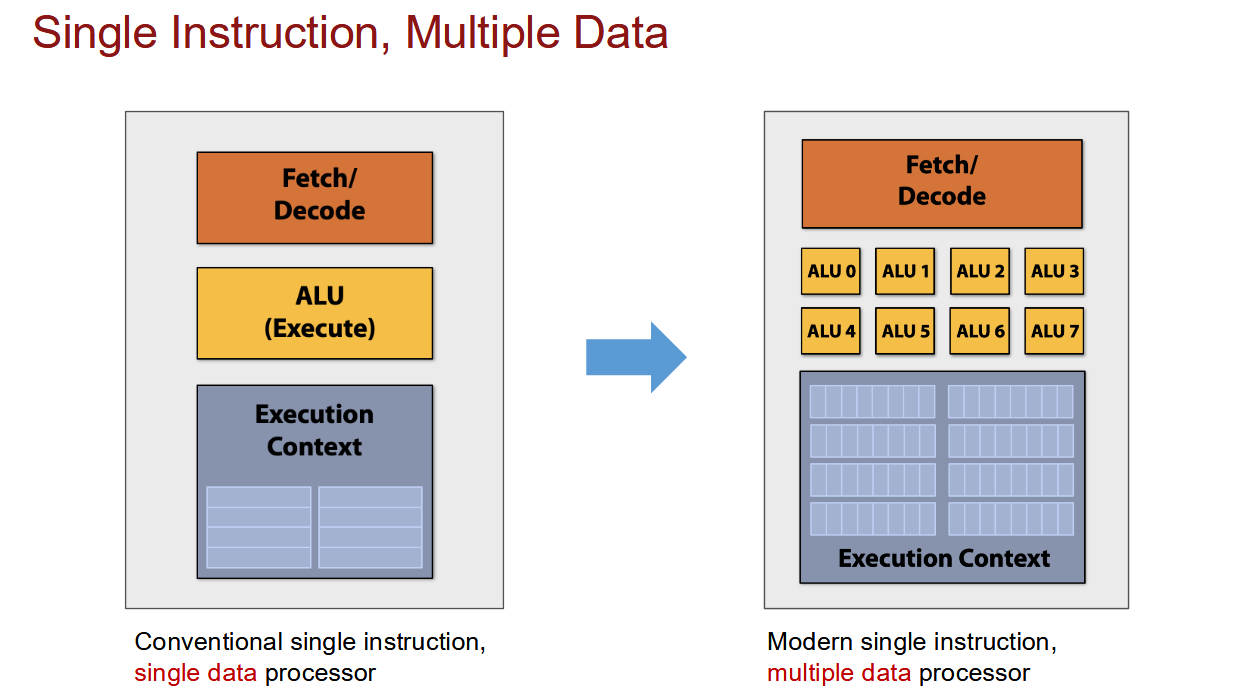
和 CPU 上的单线程编程不同,在 CUDA 上进行编程时,通常是一条指令对应多个计算单元(Single Instruction, Multiple Data)。同样的指令会被广播给多个计算单元,通过增加 ALU 的数量来提高计算能力。
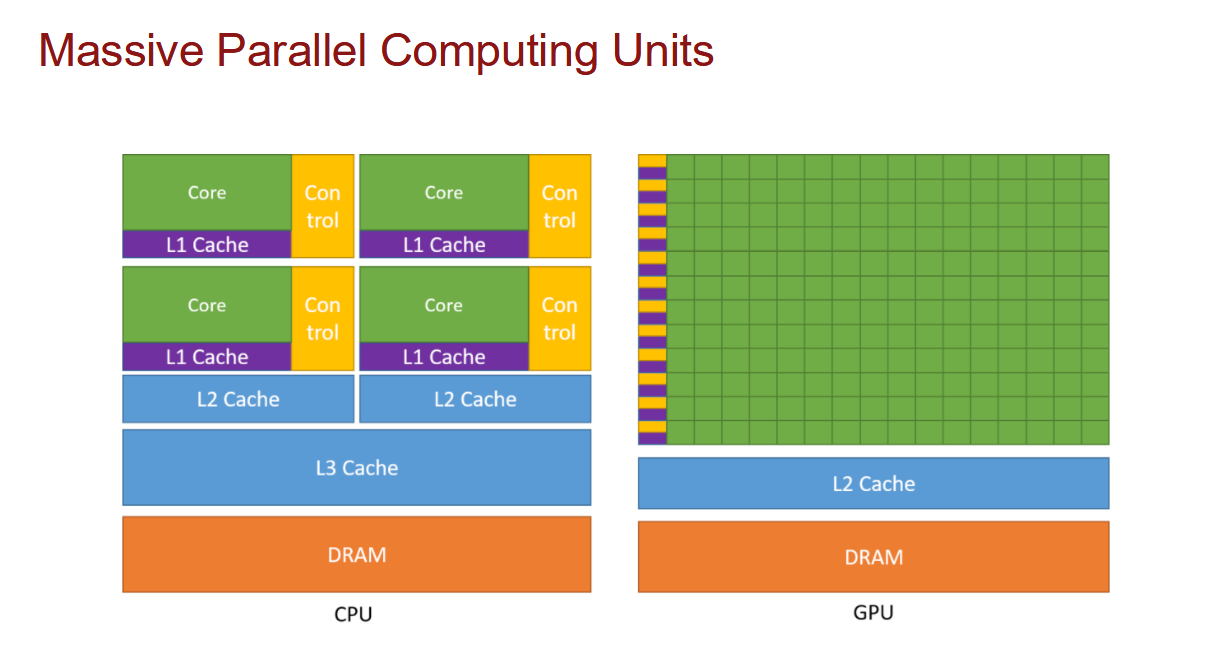
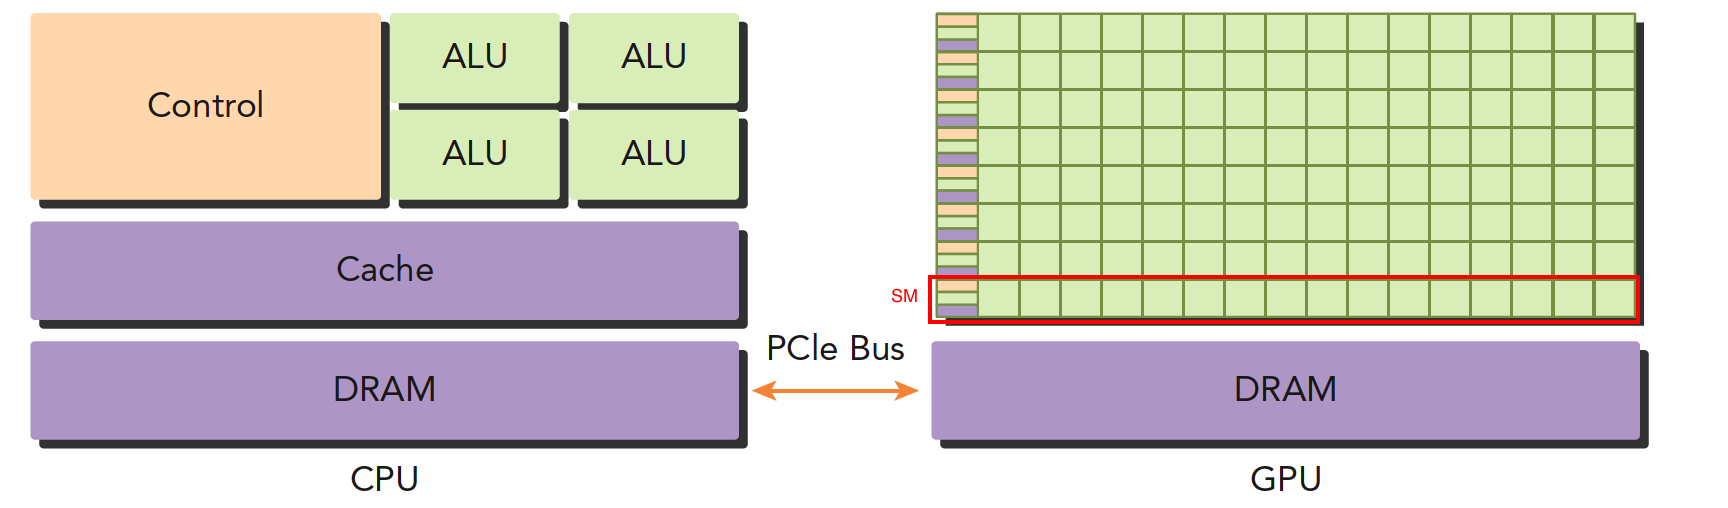
上图展示了 GPU 和 CPU 在体系结构上的差异。左图中的 CPU 只有四个 Core,每个 Core 中还有大量的资源分配给了控制单元和 L1 Cache。右图中的 GPU 则有相当多的 Core,一组 Core 才会共享一套控制单元和 Cache(其实就是 SM,但是在这里没有显式标注)。
CUDA Programming Abstractions
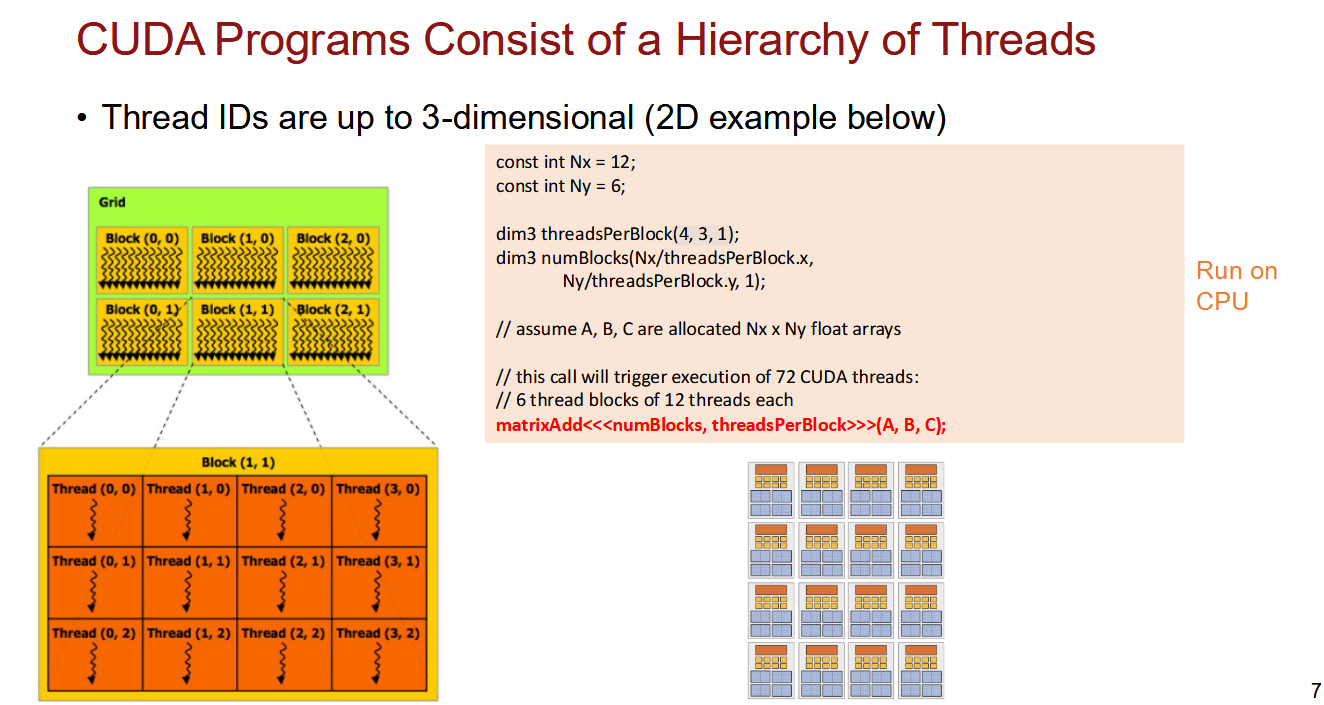
右边是一个 CUDA 程序示例:Nx 和 Ny 定义了矩阵在 x 和 y 方向上的大小,matrixAdd<<<numBlocks, threadsPerBlock>>>(A, B, C) 计算了矩阵 A 和 B 的和,并将结果存储在矩阵 C 中,函数 matrixAdd 是一个核函数(Kernel Function)。
numBlocks 和 threadsPerBlock 源自 CUDA 对 GPU 硬件的抽象(参考 理解 CUDA 中的 thread, block, grid 和 wrap):
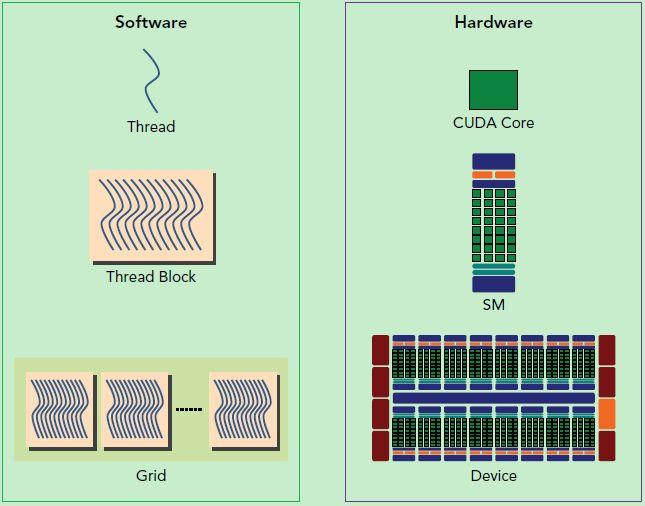
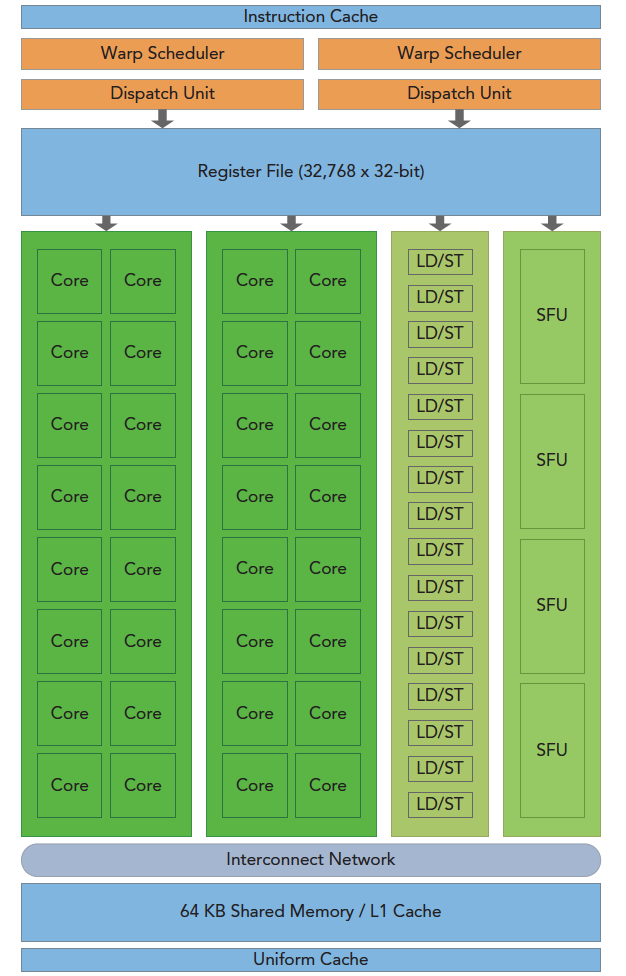
从硬件上看,流式处理器(Streaming Multiprocessors, SM)是 GPU 的核心计算单元,一个 SM 内根据 GPU 架构不同,包含不同数量的 CUDA Core(又称为 Streaming Processor, SP)、共享缓存(Shared Memory / L1 Cache)、寄存器(Register File)、线程束调度器(Wrap Scheduler)等。线程束(Wrap)是 SM 中基本的执行单元,一个 Wrap 包含 32 个 Thread。一个 CUDA Core 可以执行一个 Thread,一个 SM 可以同时执行多个 Wrap。SM 内的线程束调度器负责调度 Wrap 的执行,SM 内的共享缓存和寄存器是所有 Wrap 共享的。也因此,一个 Wrap 会被要求在同一个时钟周期内执行同一条指令(SIMT 架构, Single Instruction, Multiple Thread)。
从软件上看,CUDA 抽象成 Grid、Block 和 Thread 三个层次。Grid 是 Kernel 启动的整体,一个 Grid 对应一次 Kernel 的执行。Grid 中包含多个 Block,把一个大的计算任务分解成多个 Block,一个 Block 内的 Thread 共享内存。在上面的案例中,一个 12 * 6 的矩阵乘法被拆分成了 3 * 2 个 Block,每个 Block 内有 4 * 3 个 Thread。核函数在 Thread 上执行。
当一个核函数开始执行时,SM 会被分配一个或多个 Block(这取决于 Block 大小和 SM 的大小),Block 被拆成若干 Warp。同一个 SM 上,可能有不同 Block 的不同 Warp 在执行。SM 内的线程束调度器负责调度 Wrap 的执行。
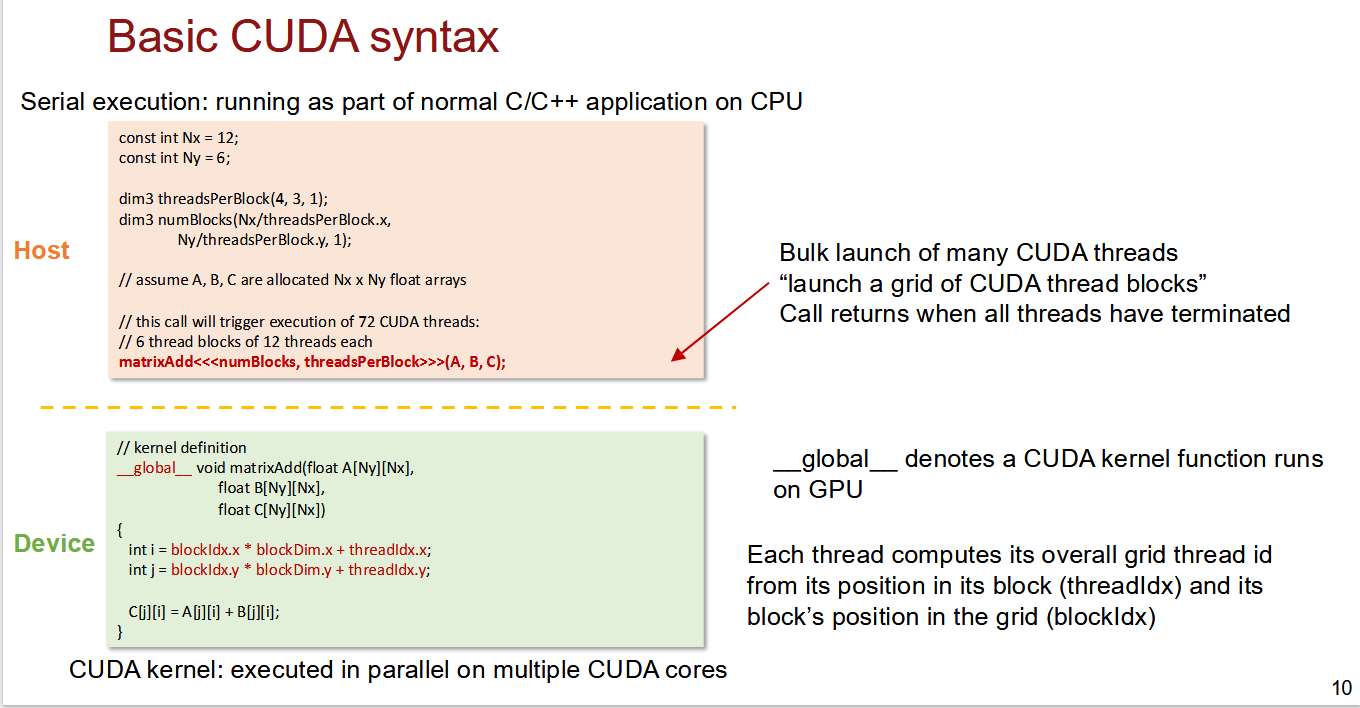
Host 端在 CPU 上执行,Device 端在 GPU 上执行。
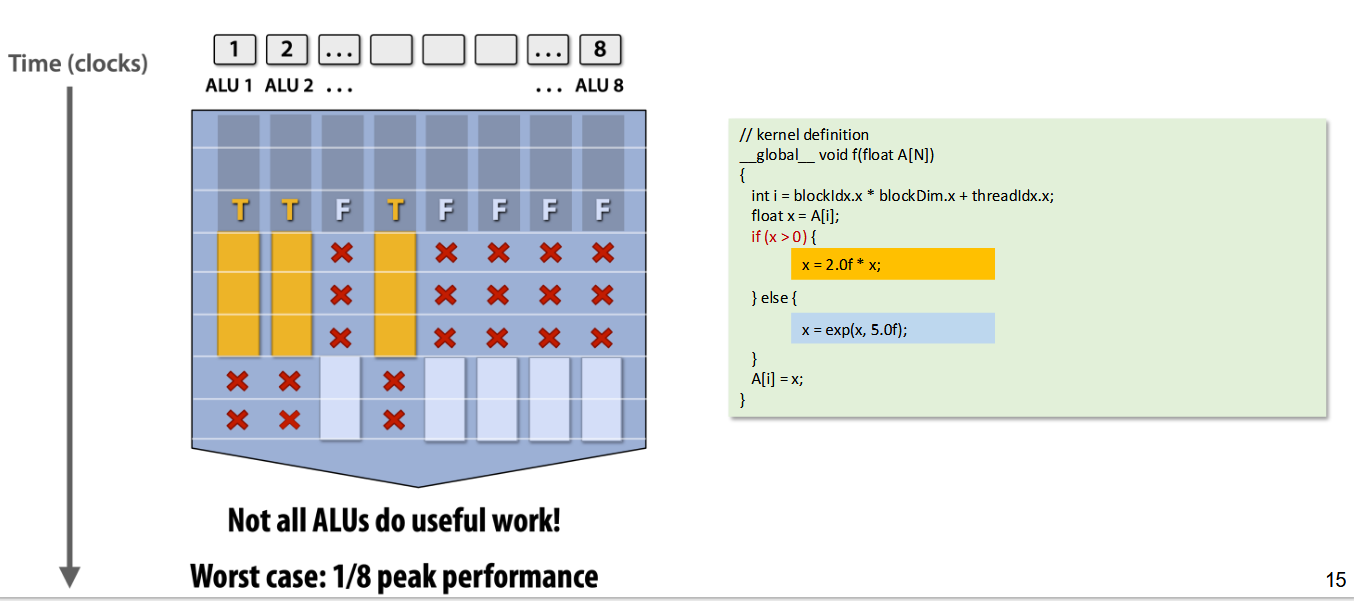
之前提到,一个 Wrap 内的所有 Thread 会在同一个时钟周期内执行同一条指令。当遇到分支指令时,不同的 Thread 可能会执行不同分支。因此,硬件只能串行化执行各分支路径,并通过掩码屏蔽不参与当前路径的线程。右侧是一段典型的 CUDA Kernel,每个线程读取一个数组元素后执行条件判断,左侧展示了 8 个 ALU(代表一个执行单元内的 8 条 SIMD 通道)随时间推进的状态。
因此,一致执行(Coherent Execution)是 GPU 高效执行的关键。不一致的执行(Divergent Execution)会导致线程束内的线程被迫串行化执行,降低了 GPU 的吞吐量。
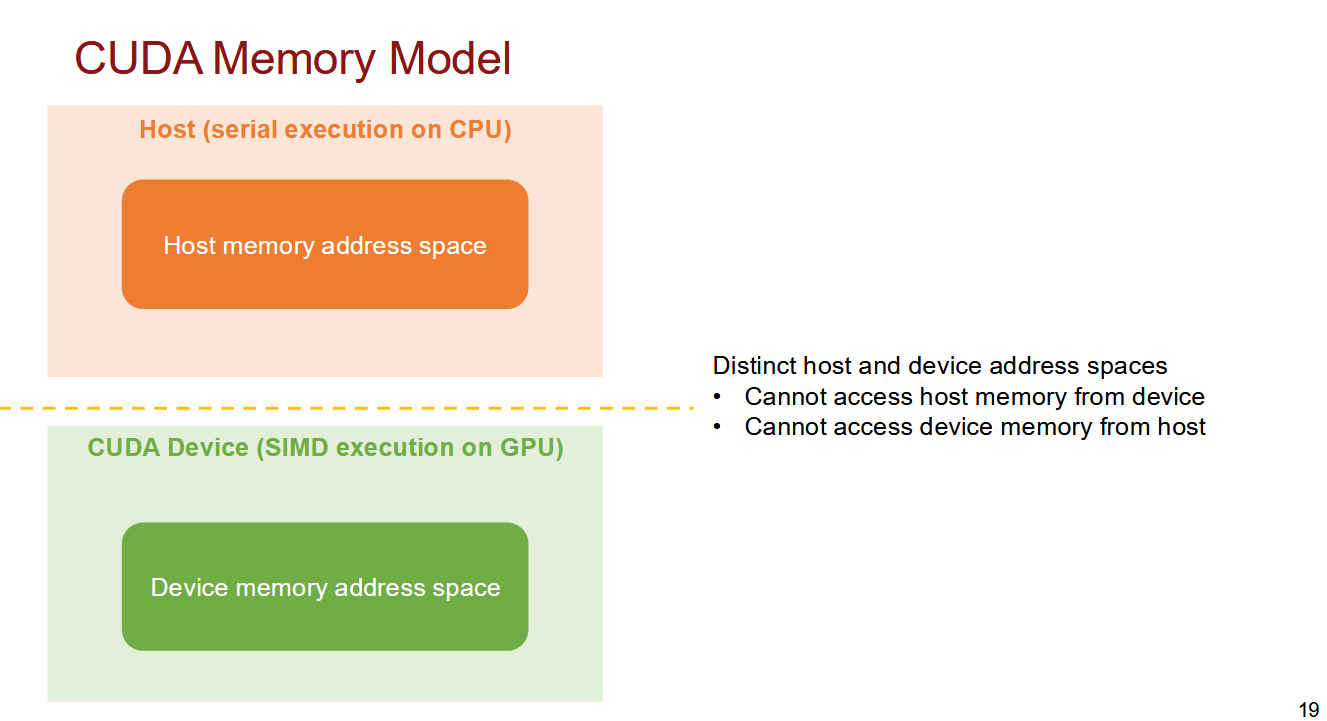
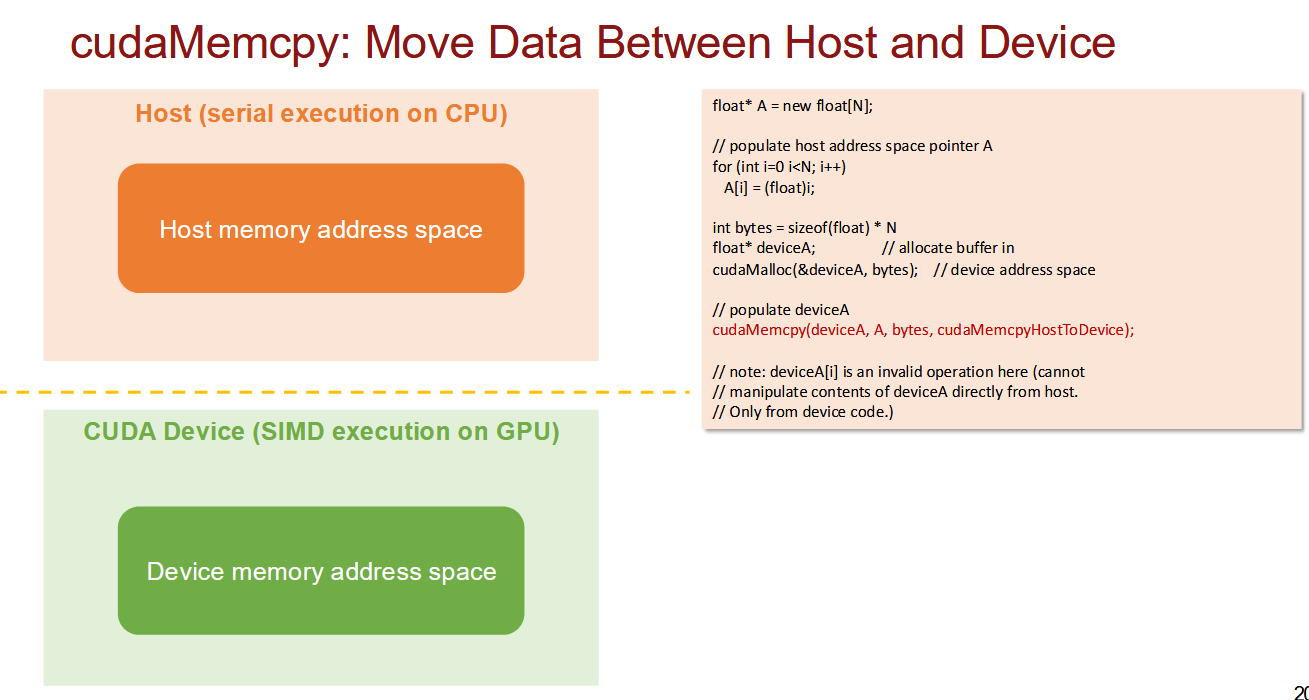
Host 与 Device 的地址空间是分离的,二者不能互相访问。为了在二者间搬运数据,CUDA 提供了 cudaMemcpy 函数。cudaMemcpy 的第一个参数是目标地址,第二个参数是源地址,第三个参数是要搬运的数据大小,第四个参数是搬运的方向。搬运的方向有三种:cudaMemcpyHostToDevice、cudaMemcpyDeviceToHost 和 cudaMemcpyDeviceToDevice。
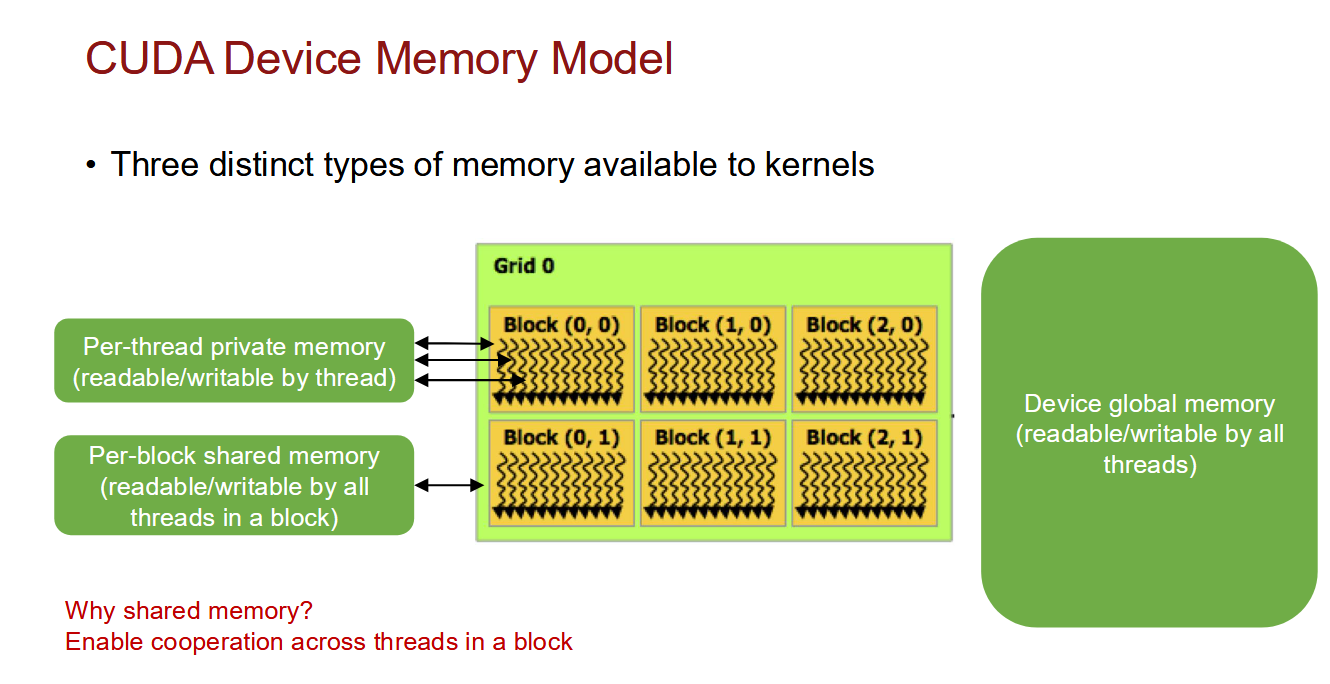
| 内存类型 | 作用域 | 图示位置 | 核心特征 |
|---|---|---|---|
| Per-thread private memory | 单个线程独占 | 图中每个波浪线小格子(线程)旁标注 | 每个线程可读/写自己的私有数据,通常映射到寄存器或本地内存,生命周期随线程。 |
| Per-block shared memory | 同 Block 内所有线程共享 | 箭头指向整个 Block(橙色框) | 位于芯片上的高速 SRAM,延迟极低;仅对块内线程可见,Block 之间不可见。 |
| Device global memory | Grid 内所有线程 + Host | 右侧独立的大绿色块 | 即 GPU 显存(DRAM),容量大但延迟高;Host 通过 cudaMemcpy 与其交换数据。 |
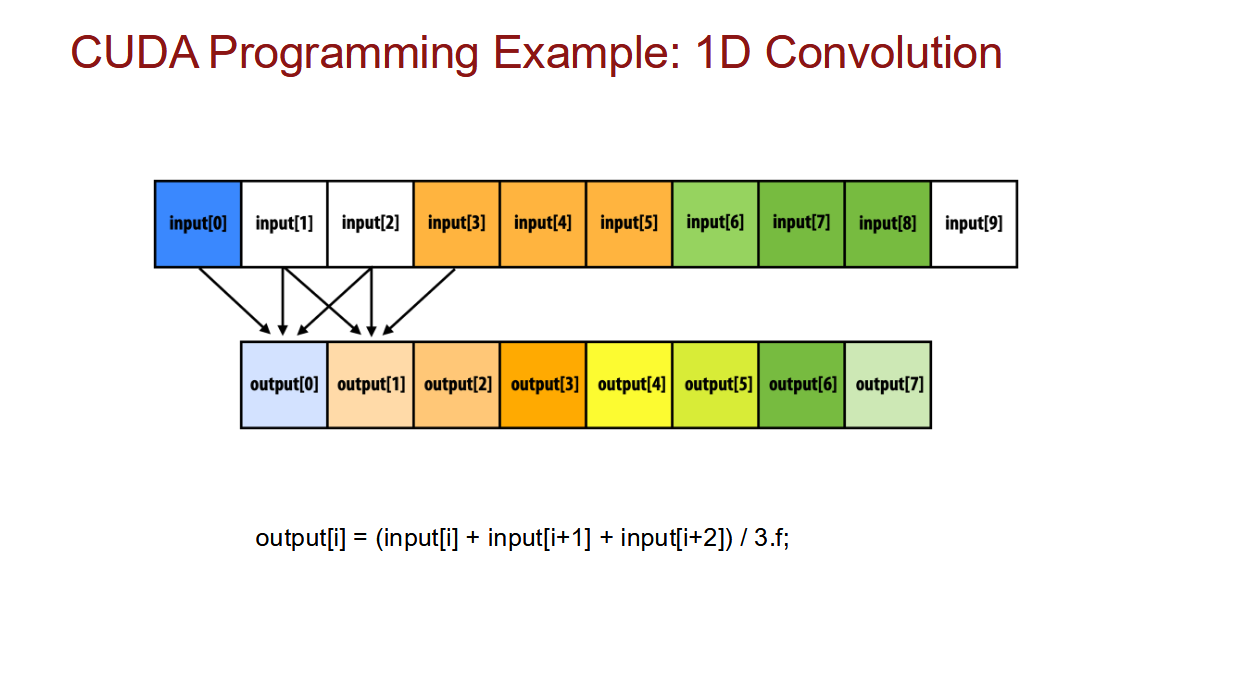
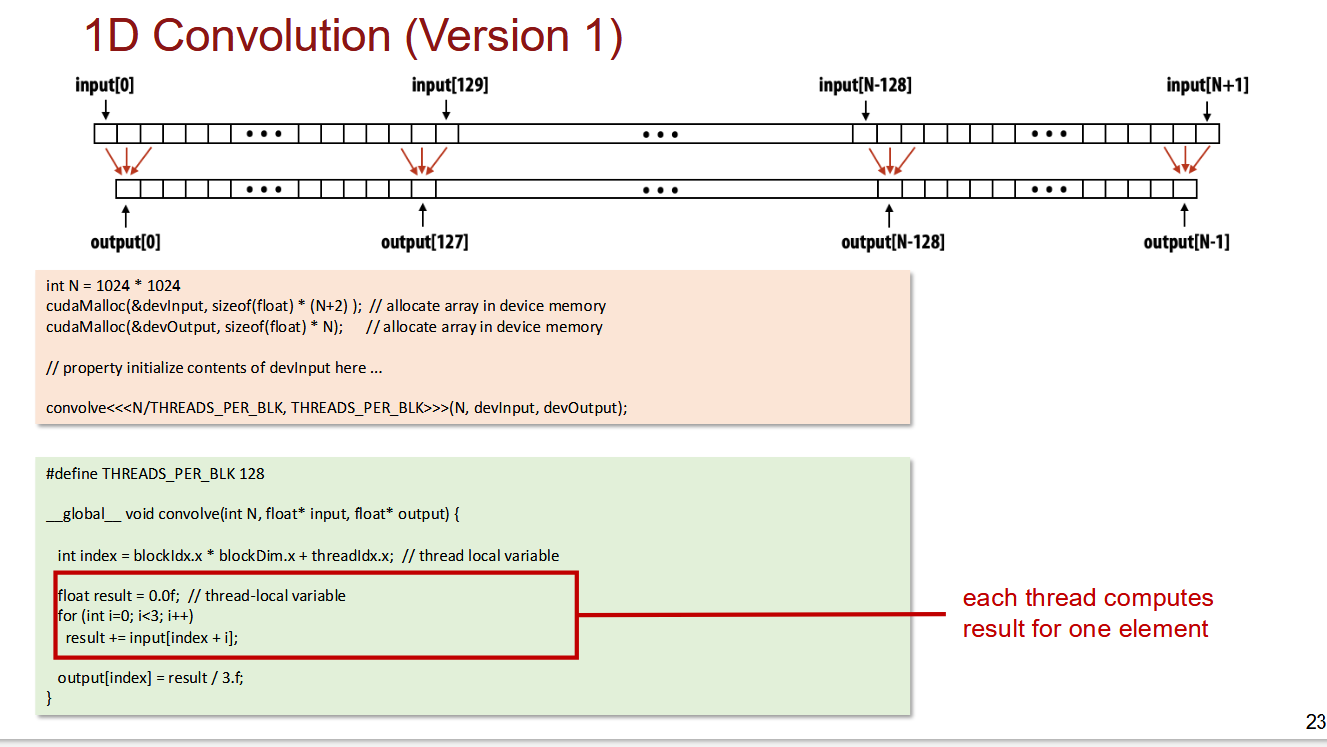
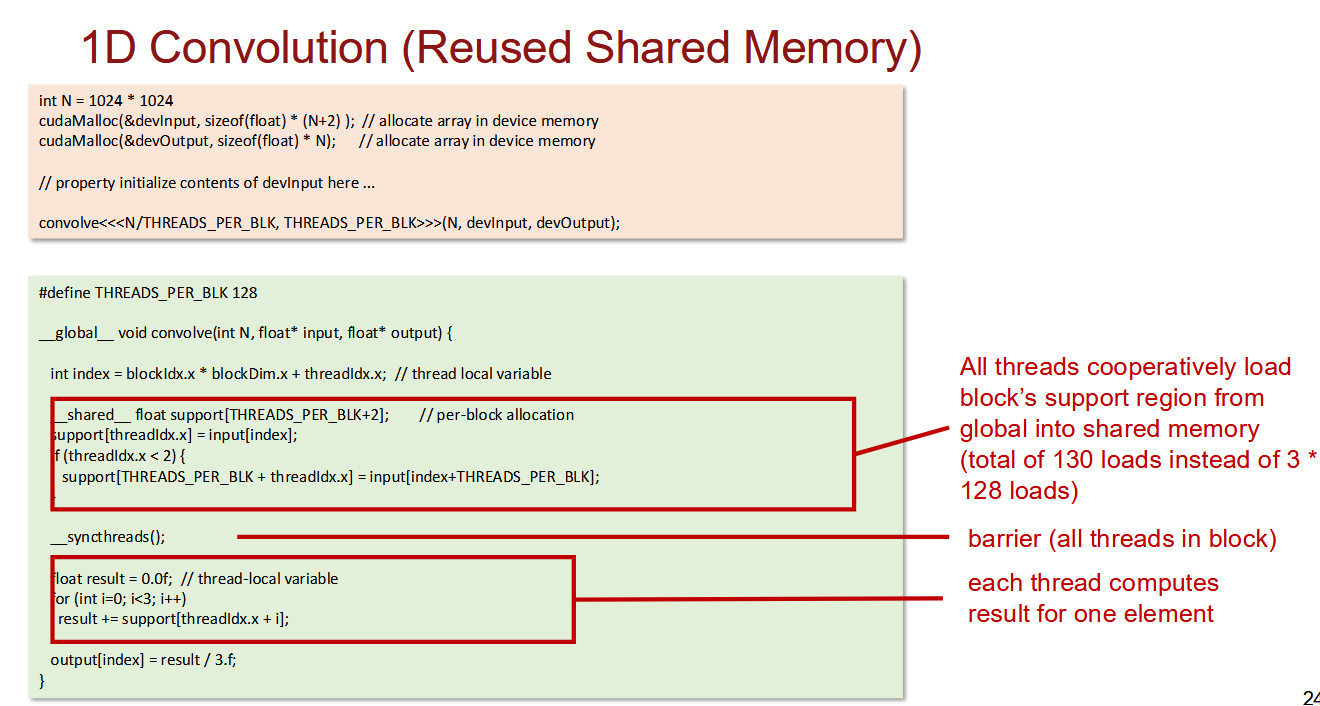
以一个一维卷积为例,Version 1 是一个使用 Global Memory 的实现,Version 2 是一个使用 Shared Memory 的实现。Version 1 中每个线程都要访问全局内存中的输入数据,导致大量的全局内存访问。
Version 2 使用了 Shared Memory:
__shared__ float support[THREADS_PER_BLK+2];  // per-block allocation
support[threadIdx.x] = input[index];
if (threadIdx.x < 2) {
    support[THREADS_PER_BLK + threadIdx.x] = input[index+THREADS_PER_BLK];
}
__shared__ float support[THREADS_PER_BLK+2] 在每个 Block 内分配了一个共享内存数组 support,大小为 THREADS_PER_BLK + 2(这是由于卷积运算而引入的边界处理)。if (threadIdx.x < 2) 让线程 0 和线程 1 额外加载右侧的 2 个元素到 support[128] 和 support[129]。
__syncthreads;__syncthreads 确保整个 Block 的所有线程都完成加载后(到达这个程序点),才允许任何线程进入计算阶段,避免读到脏数据。
float result = 0.0f; // thread-local variable
for (int i=0; i<3; i++)
    result += support[threadIdx.x + i];

output[index] = result / 3.f;
此时每个线程从片上的 Shared Memory 中连续读取 3 个值,计算卷积结果并写回全局内存。由于 Shared Memory 的访问延迟远低于 Global Memory,这种实现方式显著提高了性能。
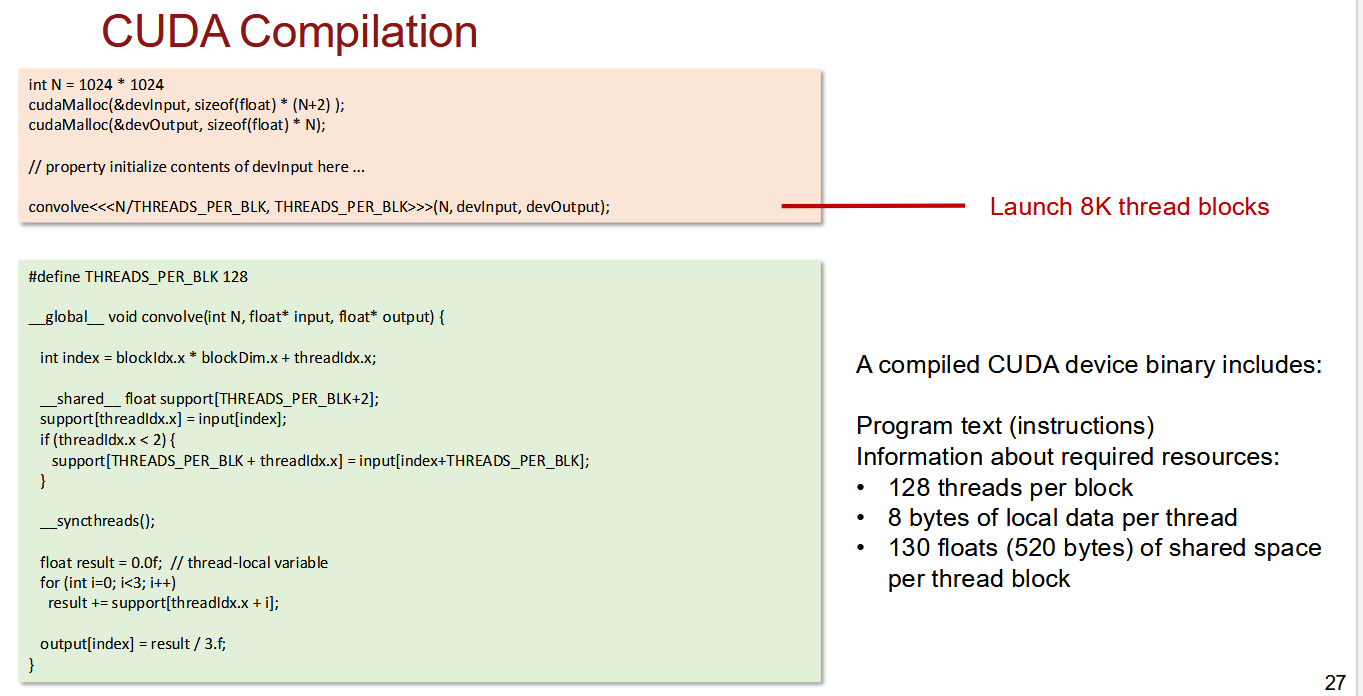
一个编译后的 CUDA Device Binary 应该包含:
- 程序文本;
- 需要的资源的声明,在这个例子中:
- 每个 Block 有 128 个 Threads;
- 每个 Thread 需要 8 Bytes 的局部数据;
- 520 Bytes 的共享内存;
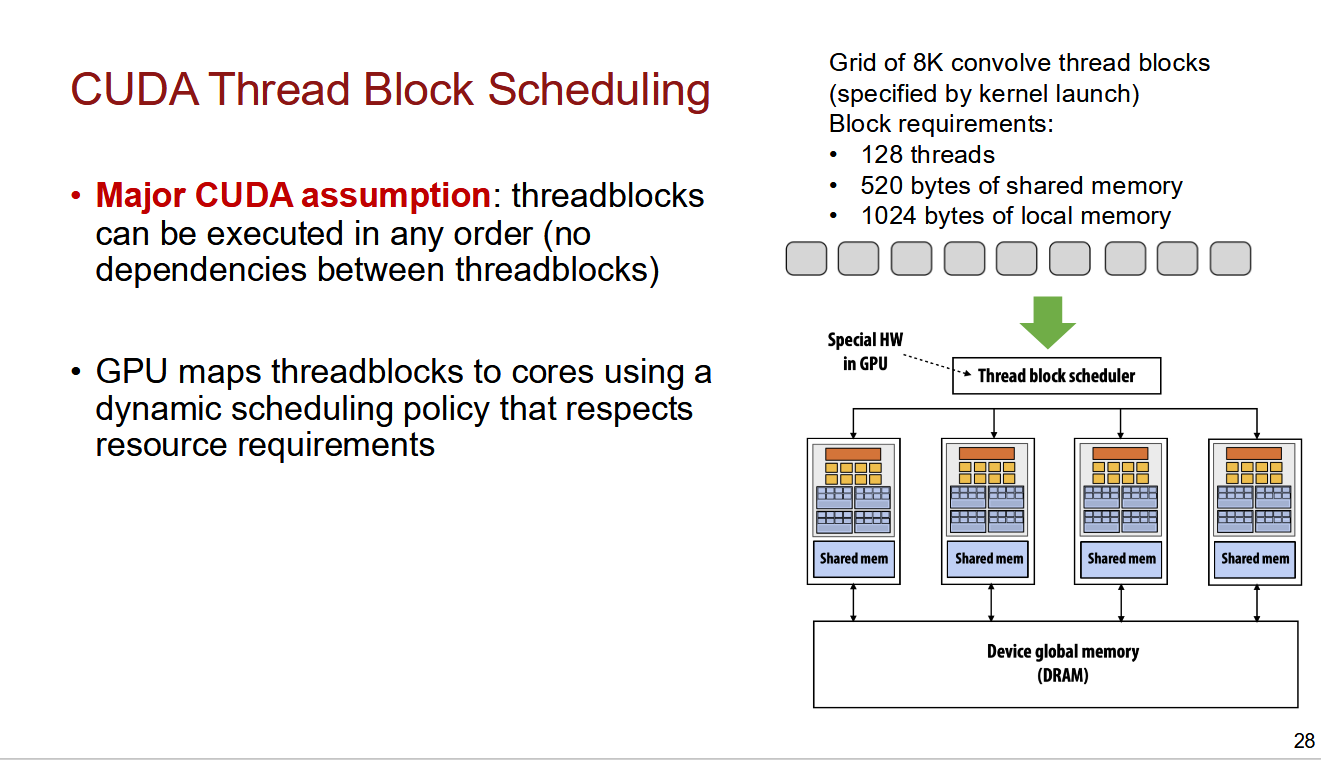
CUDA 的主要假设:Blocks 之间是独立的无依赖关系的。Blocks 可以以任意顺序执行。
基于这一假设,GPU 会根据需求,动态的调度 Blocks 到 SM 上执行。
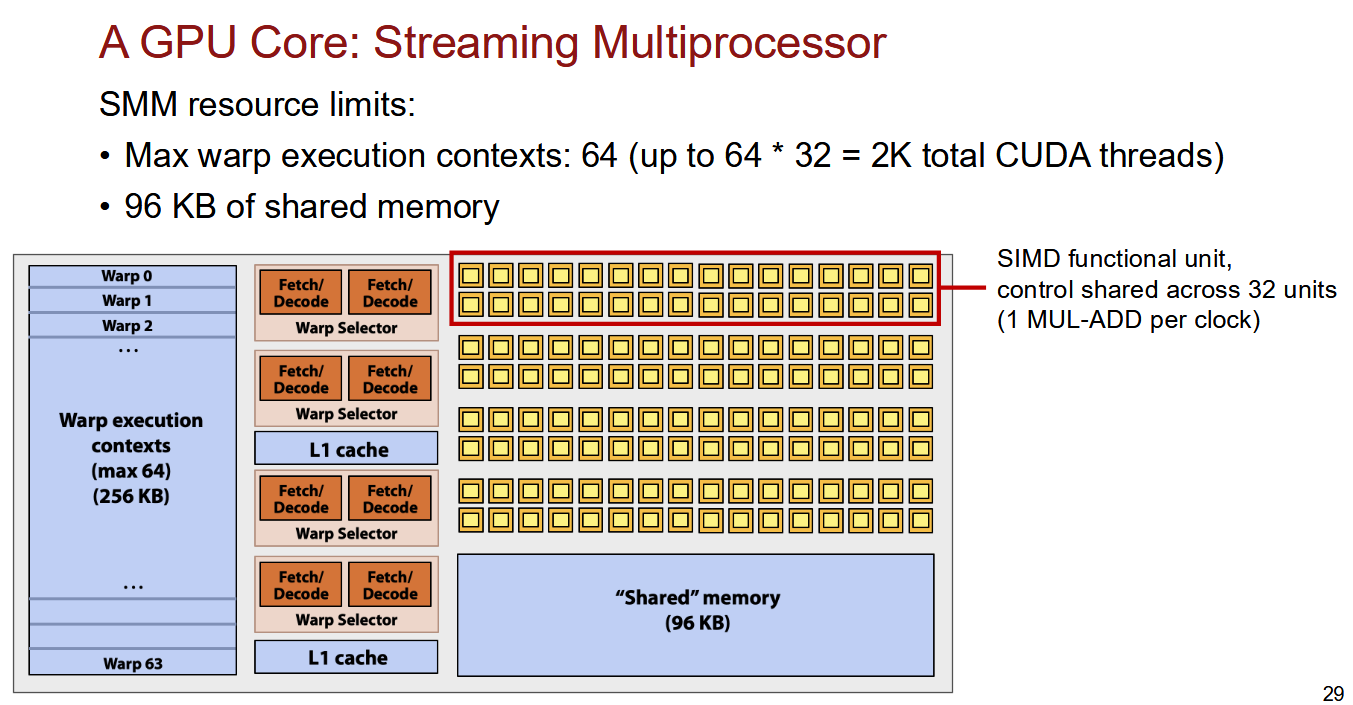
上图展示了 SM 的内部架构。一个 Warp 固定包含 32 个线程,因此一个 SMM 可同时驻留最多 64×32=2048 个 CUDA 线程的上下文(寄存器状态、程序计数器等)。正是因为 SMM 能同时保有这么多 Warp,当某个 Warp 因为等待 Global Memory 数据而阻塞时,硬件可以零开销切换到另一个就绪 Warp 继续执行。96 KB Shared Memory 是供 Block 内线程高速共享的片上 SRAM。
接下来,演示上文的 convolve 函数是怎么被运行的:
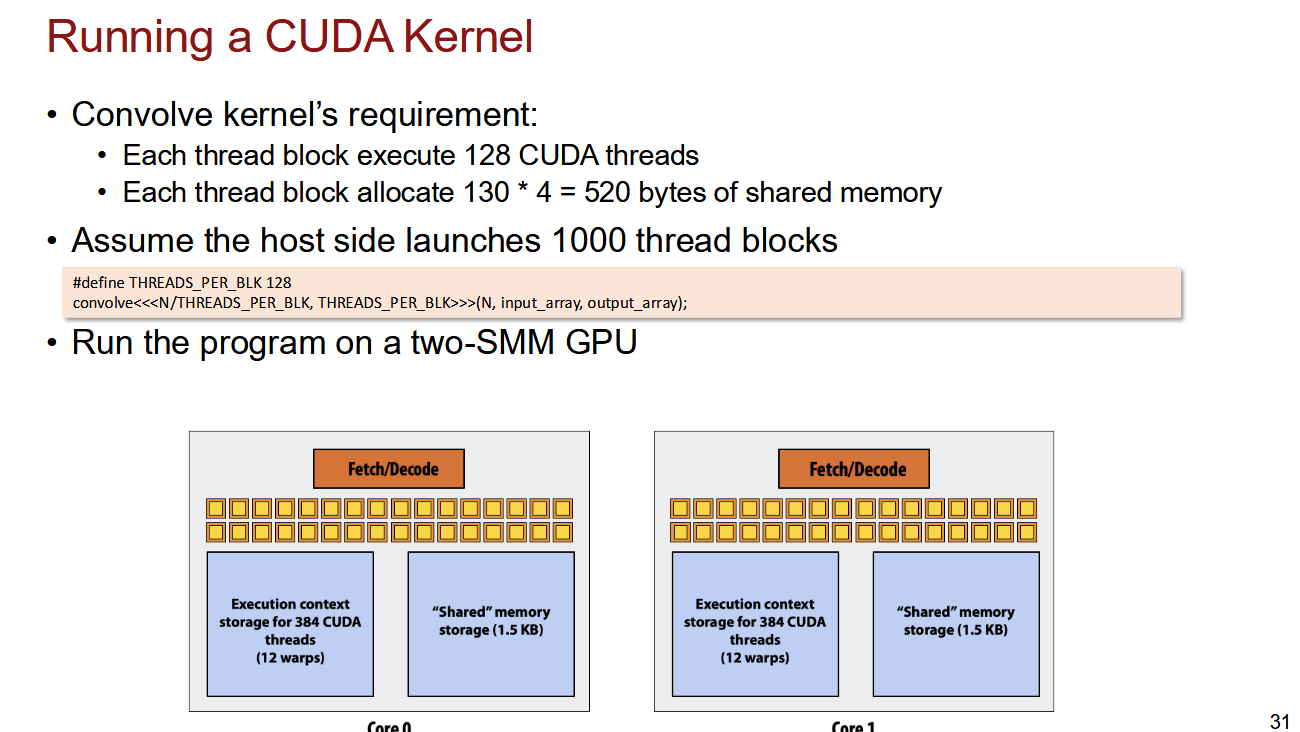
假设线性卷积在一个只有两个 SM 的 GPU 上运行,每个 SM 可以容纳 12 个 Wrap(284 个 Threads),Shared Memory 大小为 1.5KB。
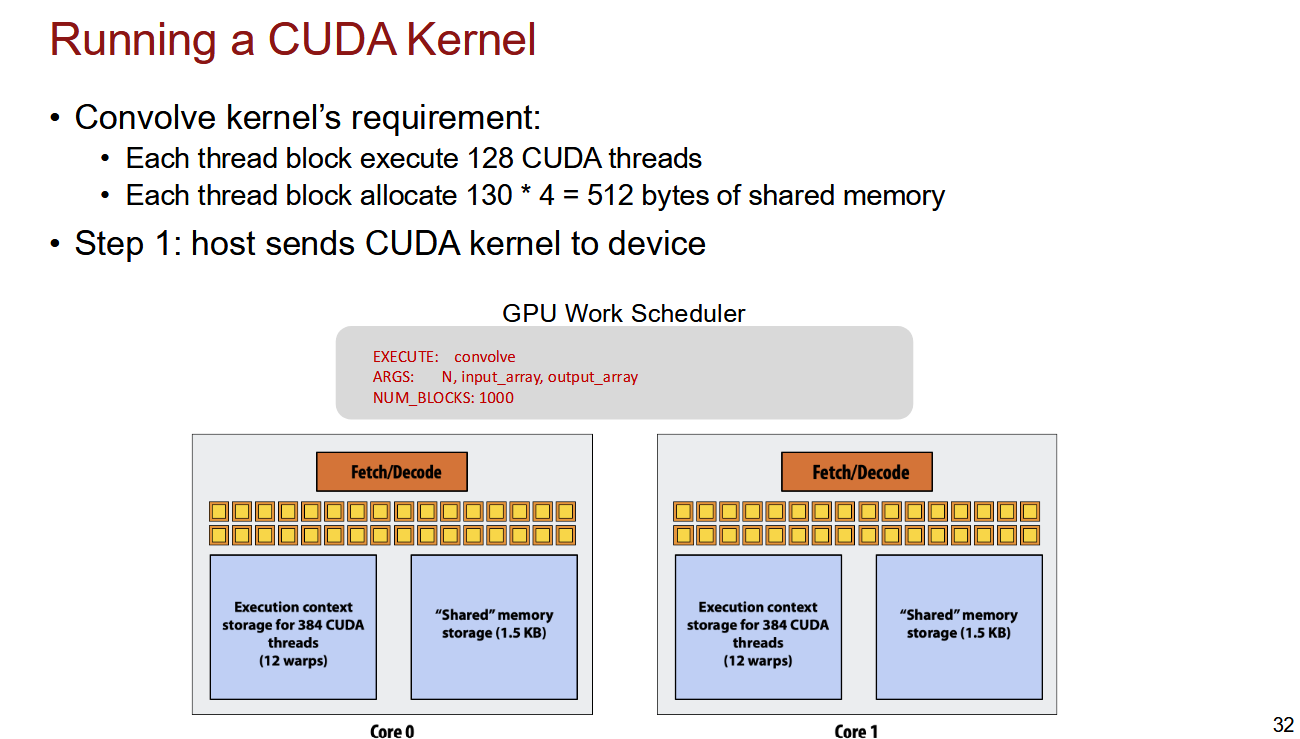
第一步:计算 Kernel 的资源需求,并发送给 Device(GPU)。
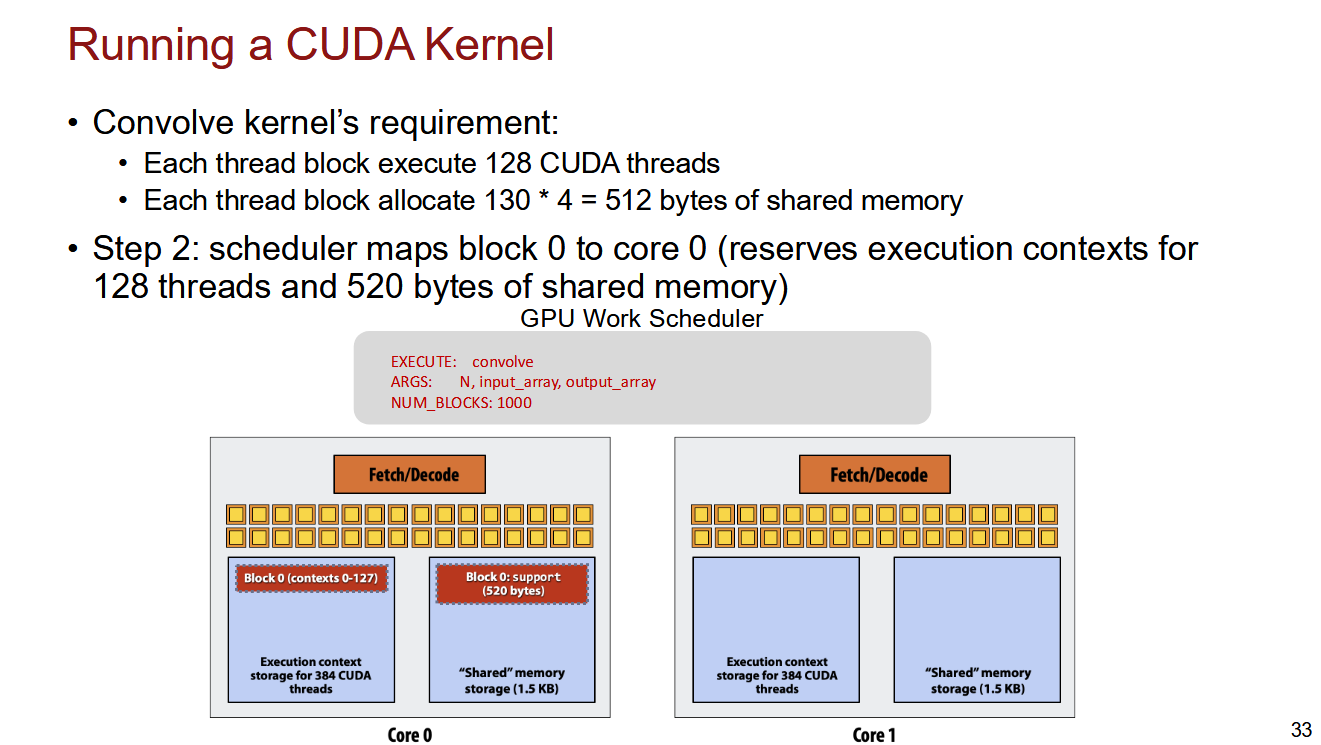
第二步:在 Core 0 上为 Block 0 预留资源。
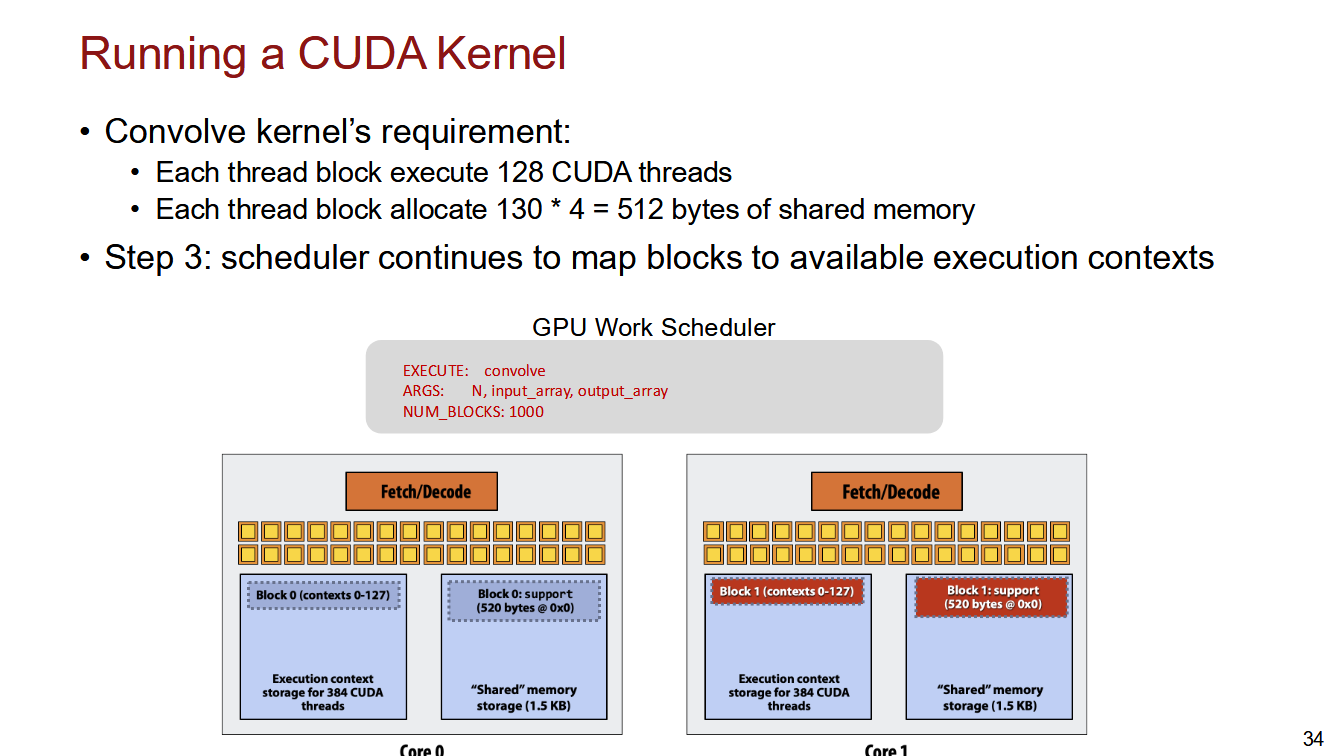
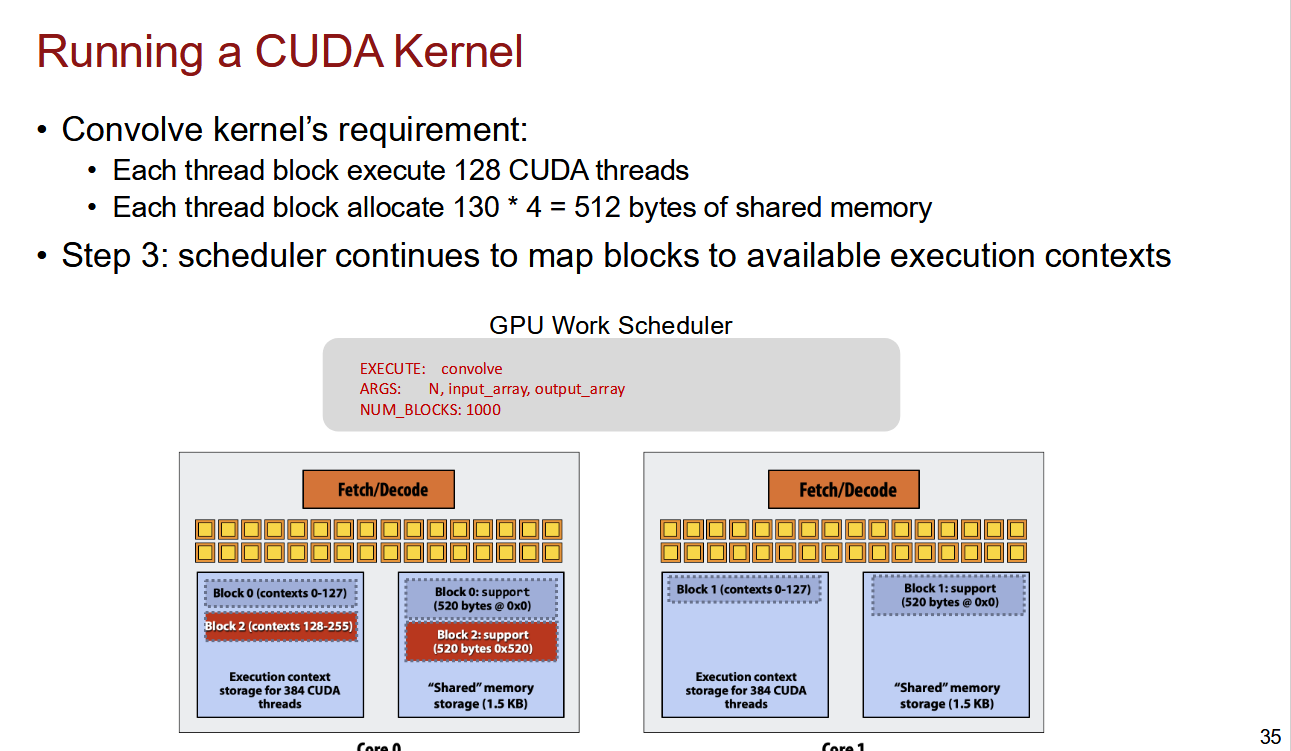
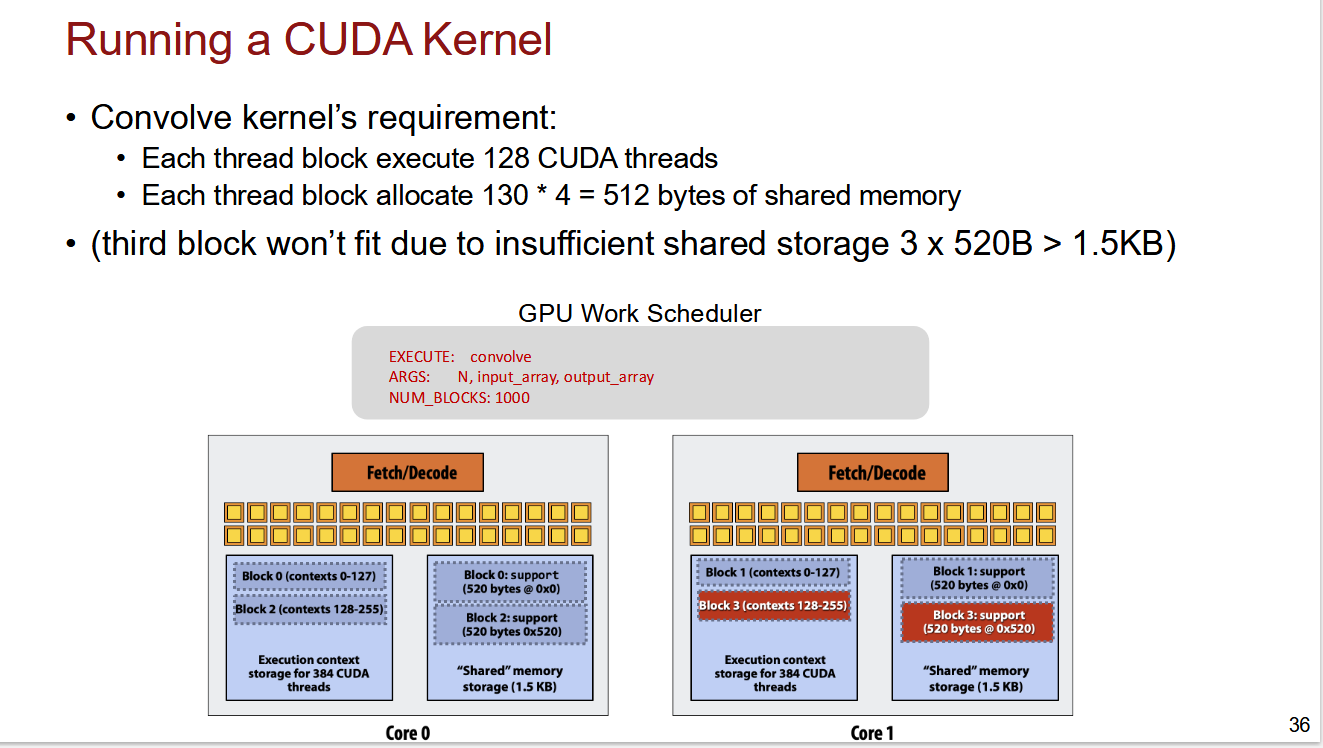
第三步:继续在 Core 1 上为 Block 1 预留资源,在 Core 0 上为 Block 2 预留资源... 直到 Block 4 不再足以被分配到任何一个 SM 上。
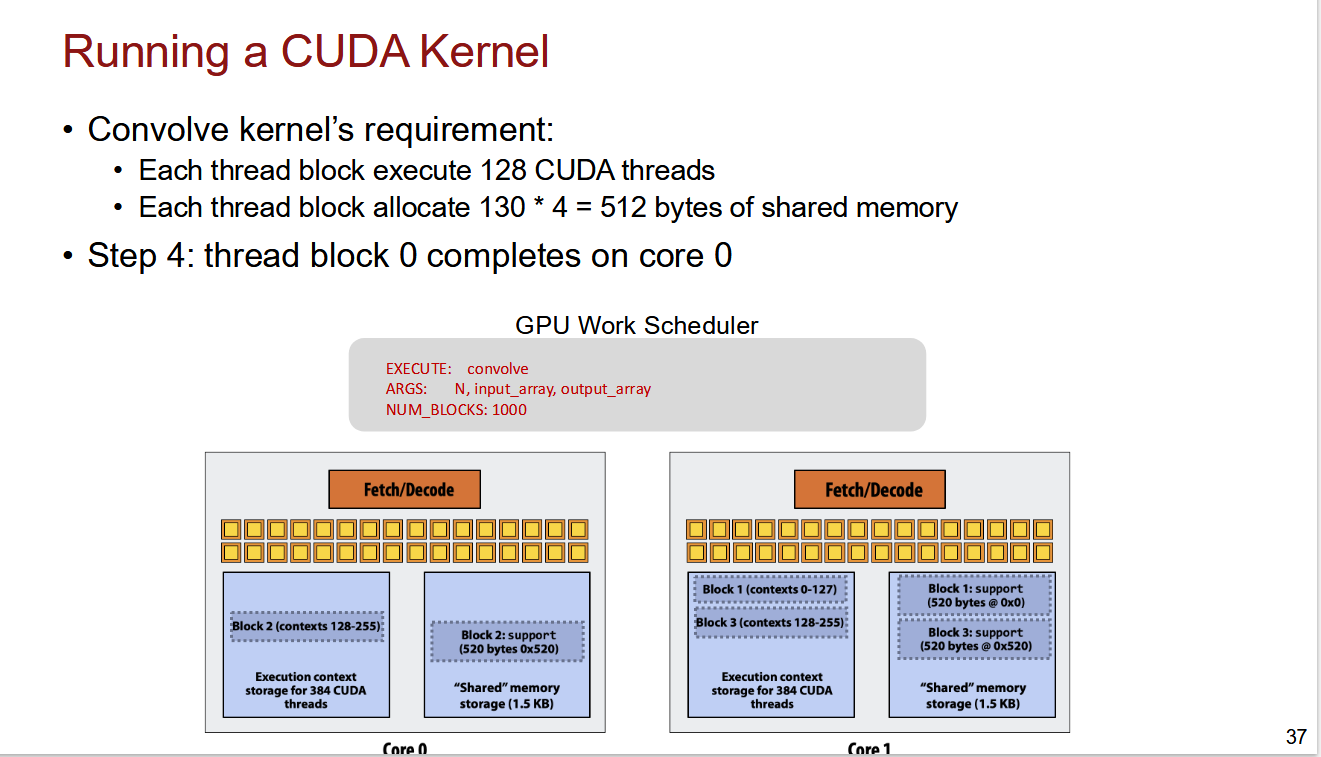
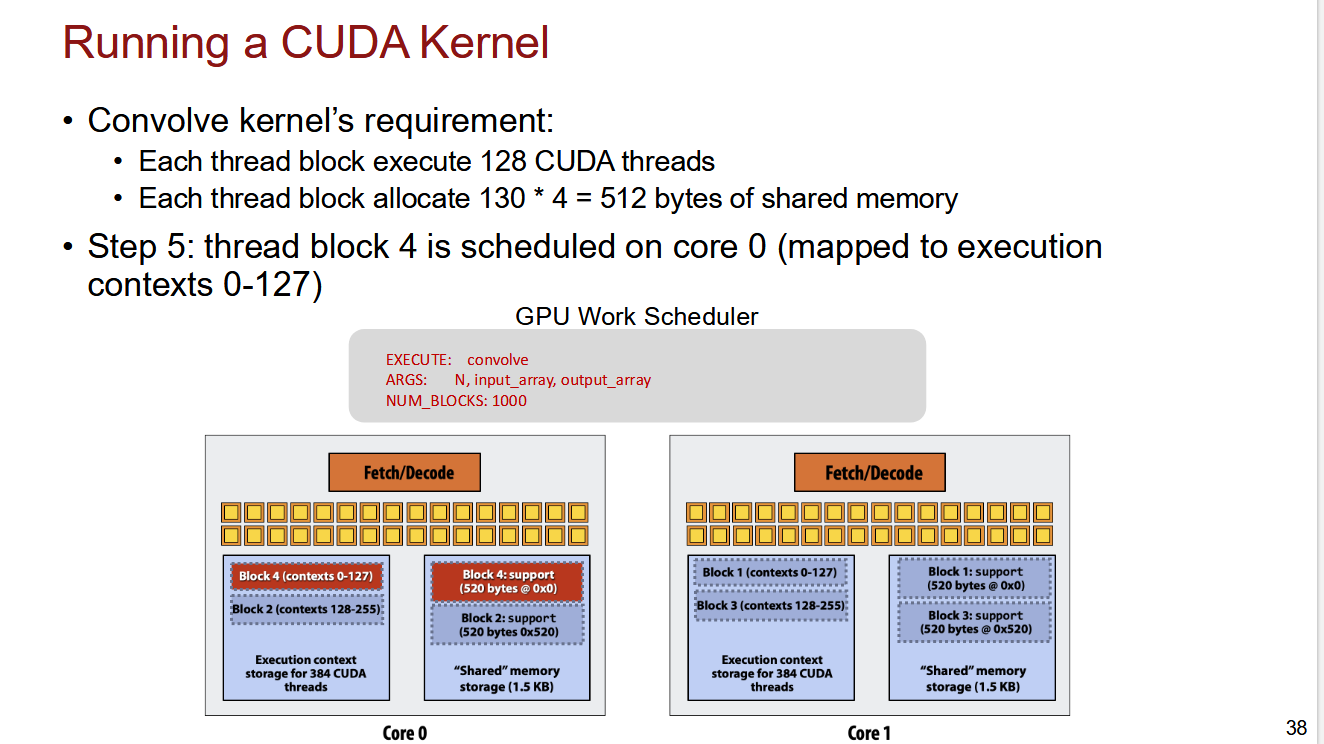
第四步/第五步:Block 0 执行完毕,释放资源,Core 0 上为 Block 4 预留资源,以此类推。
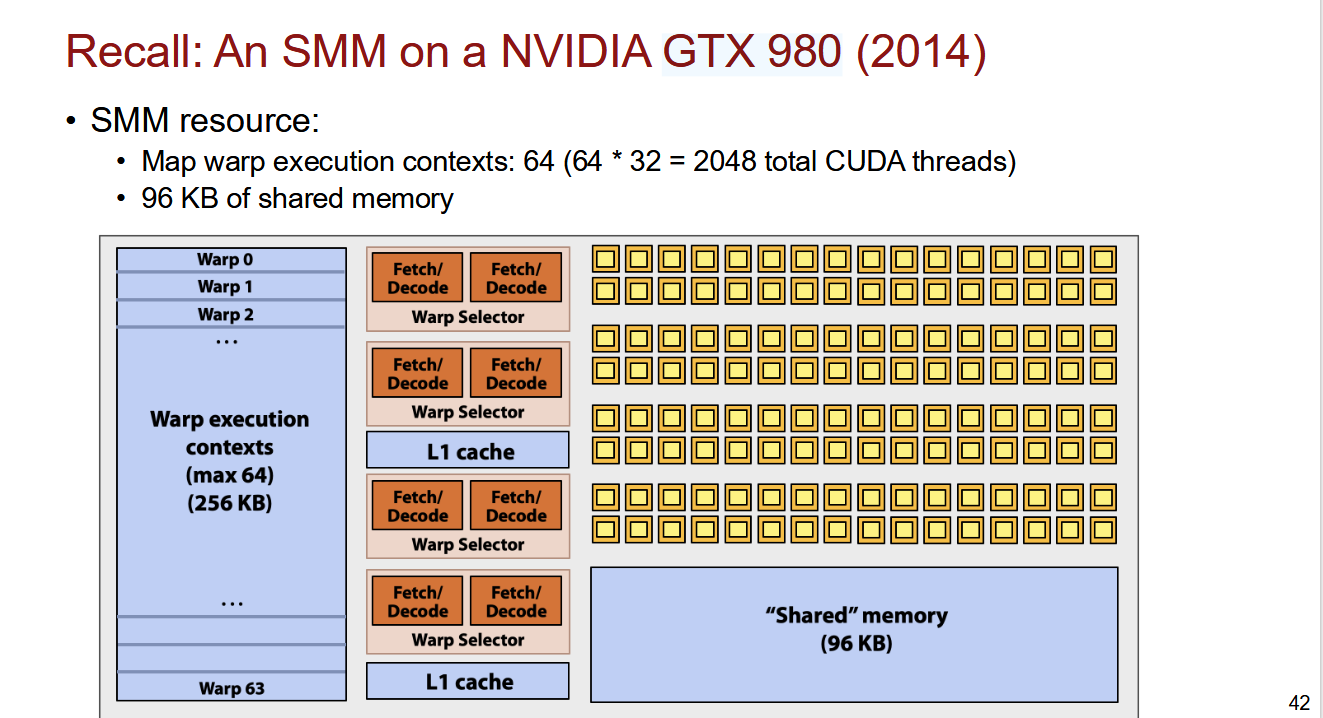
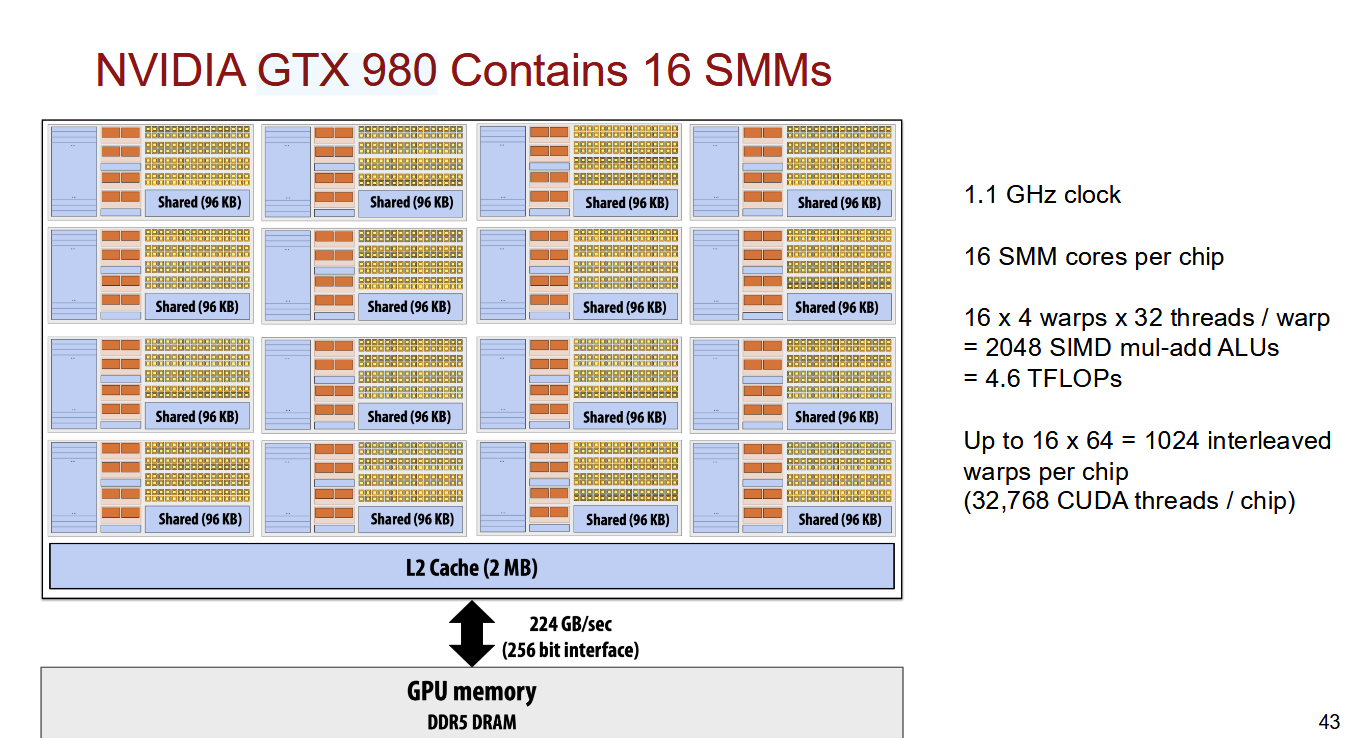
上面的 SM 是 Nvidia GTX 980 的架构。
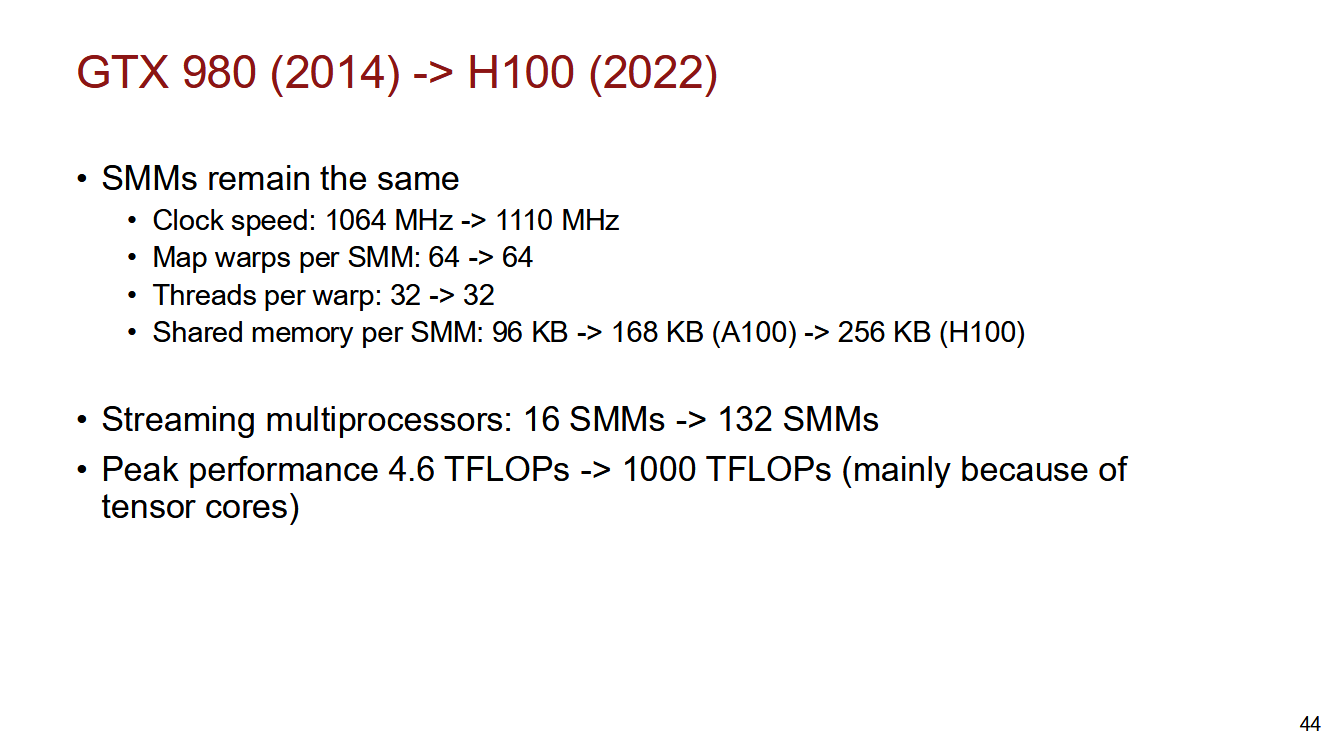
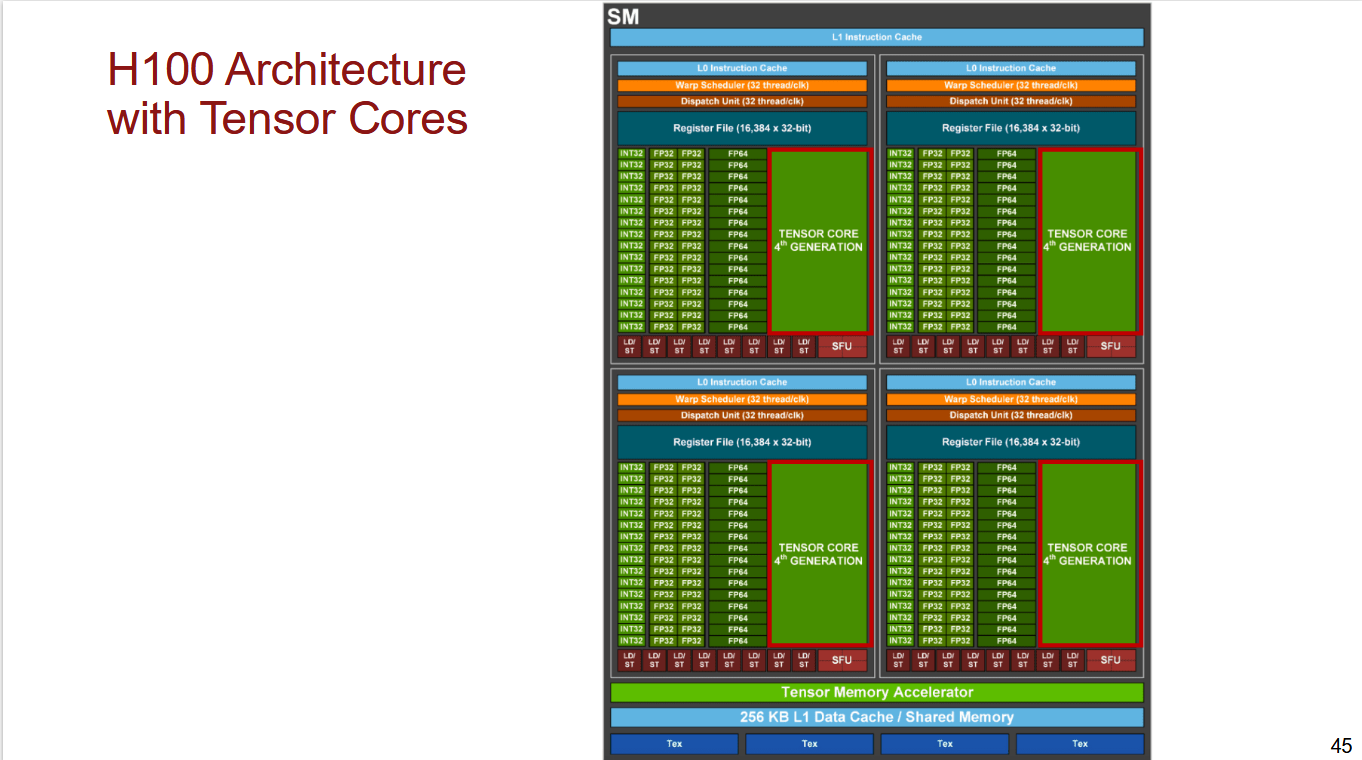
在 H100 上,SM 的架构没有什么变化,但是 Peak Performance 从 4.6 TFLOPS 提升到了 1000 TFLOPS,这主要来自于 Tensor Core 的引入。
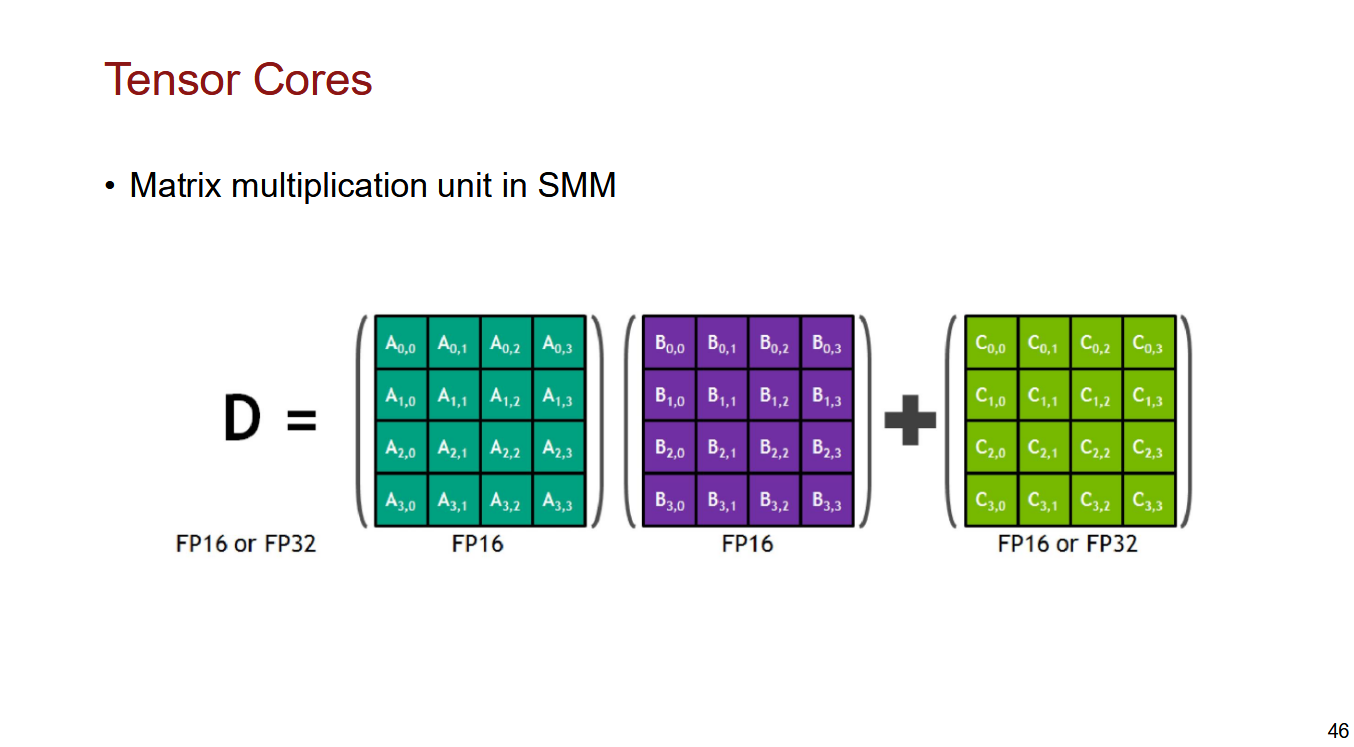
Tensor Core 专门为深度学习引入,是个专门硬连线(hardware-wired)的矩阵运算单元,它一次性计算的是